Acabei de voltar de São Paulo, onde fui pra tirar um visto acadêmico pros Estados Unidos. Gostaria de compartilhar algumas dicas que podem ser úteis pra quem for passar pelo mesmo processo.
Hospedagem: Eu recomendo o hotel Intercity Nações Unidas, que até onde eu sei é o mais barato nas proximidades do consulado. A estadia no fim de semana é mais barata. Eu paguei uma diária de R$ 155 (mais taxas) ficando de Domingo para Segunda-feira (minha entrevista de visto foi na Segunda). Tem um ponto de táxi na frente do hotel. Para a janta, há uns restaurantes acessíveis na Fernandes Moreira (a rua do hotel). Não recomendo a comida do hotel, que é extremamente cara e não vale o preço.
Caixas eletrônicos: Vá com dinheiro para o consulado para pagar as taxas consulares e sedex, que vão dar mais de cem reais dependendo do visto. Se você precisar de caixa eletrônico, há vários deles no Carrefour da Rua Alexandre Dumas, a cerca de duas quadras do Intercity. Tem caixa eletrônico do Banco do Brasil, Santander, Unibanco etc.
Celular, Ipod etc no consulado: Nenhum eletrônico é permitido dentro do consulado, e eles não têm mais guarda-volumes dentro do consulado. Portanto, ou não leve eletrônicos na entrevista, ou deixe as suas coisas em um dos guarda-volumes que existem na frente do consulado por sua conta e risco (foi o que eu acabei fazendo).
DS-160: O sistema de preenchimento de informações para visto mudou, e agora é tudo online, através do formulário DS-160. Eu tive uma experiência ruim com este sistema: a cada 20 minutos/meia hora o sistema me desconectava, e todas as informações que eu tinha digitado eram perdidas. A solução é a cada 20 minutos salvar um arquivo com as informações do formulário, que pode ser importado caso você seja desconectado. É dose, eu sei. Outra: você vai levar no mínimo uma hora preenchendo este formulário.
Monday, May 17, 2010


Sunday, April 18, 2010
Seminários de AstroProgramação
Ás vezes queremos aprender novas linguagens de programação, mas pela falta de tempo acabamos não conseguindo. Para acelerar o processo de aprendizado, está acontecendo no Departamento de Astronomia da UFRGS os Seminários de AstroProgramação: uma série de palestras informais, cada uma devotada a uma linguagem de programação diferente, com foco nos astrônomos.
A proposta é que a cada semana, um voluntário dê uma palestra a respeito das virtudes da linguagem de programação de sua escolha. Cada palestra deve apresentar um exemplo simples de programa (tipo "hello world"), bem como alguns códigos-fontes um pouco mais sofisticados que demonstrem a sintaxe básica etc. A duração das palestras é semelhante a de um seminário de grupo.
As linguagens abordadas foram: IDL, Perl, Python, C, Fortran 90, PHP, programação orientada a objetos com C++, paralelização (MPI) e Tcl/Tk.
Os slides apresentados nas palestras, bem como material adicional (códigos-fontes etc) estão disponíveis nesta página.
Changelog:
A proposta é que a cada semana, um voluntário dê uma palestra a respeito das virtudes da linguagem de programação de sua escolha. Cada palestra deve apresentar um exemplo simples de programa (tipo "hello world"), bem como alguns códigos-fontes um pouco mais sofisticados que demonstrem a sintaxe básica etc. A duração das palestras é semelhante a de um seminário de grupo.
As linguagens abordadas foram: IDL, Perl, Python, C, Fortran 90, PHP, programação orientada a objetos com C++, paralelização (MPI) e Tcl/Tk.
Os slides apresentados nas palestras, bem como material adicional (códigos-fontes etc) estão disponíveis nesta página.
Changelog:
- 23 Abr 2010: adicionei Tcl/Tk à lista.
- 11 Jul 2010: removi OpenMP da lista.
Tuesday, March 23, 2010
Useful Mac OS X tools for scientists/astronomers
Here are some of my preferred tools when doing science using Mac OS X. I previously had a PC laptop with Linux (Ubuntu) and Windows (Vista) and made a very smooth transition to Mac OS X. I found replacements for all the tools that I used before. Disclaimer: I am an astrophysicist, so the software listed here is biased in that respect.
You can find more resources in my delicious list of mac+astronomy links, including where to get IRAF for example.
TeX Live
Quicksilver
You can find more resources in my delicious list of mac+astronomy links, including where to get IRAF for example.
TeX Live
LaTeX distribution
TeXshop
TeXshop
LaTeX editor (comes with TeX Live)
LaTeXit
LaTeXit
Equation editor (comes with TeX Live)
Uses LaTeX for creating equations that can be exported as PDF, PNG. Equations can be dragged and dropped in other applications. Unfortunately the drag and drop does not work with OpenOffice.
TextWrangler
Uses LaTeX for creating equations that can be exported as PDF, PNG. Equations can be dragged and dropped in other applications. Unfortunately the drag and drop does not work with OpenOffice.
TextWrangler
Useful for editing source code in different programming languages and codifications.
MacPorts
MacPorts
Package of command-line open source software (like Fink), which is an updated version of DarwinPorts. Need Python, gawk, wget, aspell? Use Macports. The functionality is quite similar to Debian's apt-get for installing software. port search [software] searches for available software. sudo port install [software] downloads, compiles and install new software and its dependencies for your architecture.
Quicksilver
Quick way of launching applications. Press Ctrl+Spacebar and type the first few letters of the application you want to launch.
Spotlight
The builtin Spotlight (Cmd+Spacebar) is very handy when searching for papers/documents scattered through your HD. Functionality similar to Google Desktop.
Dropbox
Quite handy way to sync files between home and work. It creates a dropbox folder in your home. Each file you drop there is automatically synced over the internet in all the computers where you installed dropbox. Join it via this link and you will get more space than usual (and I will get a little bonus).
iWork's Keynote: For talks
I had been using OpenOffice Impress for a long time to prepare talks, but gave up on it. Reasons:
Synkron
Sync files between folders locally.
KeePassX
Cross-platform password databases. Work with a master password.
Inkscape
Work with illustrations, edit PDF files. It's a "free version" of Adobe Illustrator. Allows you to edit the figures in a PDF paper, for example, and export them to a talk.
Wine
To run windows programs. You can install it using MacPorts.
Other suggestions
Picasa
I personally prefer Picasa over iPhoto, but that's of course a matter of taste.
Adium
IM client which supports tons of networks, including MSN, Google Talk, AIM etc. Mac's version of Pidgin.
Spotlight
The builtin Spotlight (Cmd+Spacebar) is very handy when searching for papers/documents scattered through your HD. Functionality similar to Google Desktop.
Dropbox
Quite handy way to sync files between home and work. It creates a dropbox folder in your home. Each file you drop there is automatically synced over the internet in all the computers where you installed dropbox. Join it via this link and you will get more space than usual (and I will get a little bonus).
iWork's Keynote: For talks
I had been using OpenOffice Impress for a long time to prepare talks, but gave up on it. Reasons:
- Unstable when editing large presentations containing lots of slides/plots. Crashes commonly in linux/mac.
- Talks do not maintain their structure when you open them in different platforms (e.g., creates the talk in linux, then opens in mac).
- Gets slower as the size of the presentation increases. Especially slow in Mac.
Synkron
Sync files between folders locally.
KeePassX
Cross-platform password databases. Work with a master password.
Inkscape
Work with illustrations, edit PDF files. It's a "free version" of Adobe Illustrator. Allows you to edit the figures in a PDF paper, for example, and export them to a talk.
Wine
To run windows programs. You can install it using MacPorts.
Other suggestions
Picasa
I personally prefer Picasa over iPhoto, but that's of course a matter of taste.
Adium
IM client which supports tons of networks, including MSN, Google Talk, AIM etc. Mac's version of Pidgin.
VirtualBox
Virtualization software, i.e. you can use this to run Windows XP or Ubuntu in a separate windows.
Changelog:
Changelog:
- Apr 21 2010: Added textwrangler to the list.
Monday, March 8, 2010
Select fits files based on header keyword
The task of selecting a list of fits files based on some header keyword value is much easier to do with the IRAF task hselect. Although this example is very useful for understanding how to use pyfits and the sys module for passing parameters via command line (like bash our Perl's @ARGV).
To execute just run on the command line:
or
All bash's wildcards (*, ?, etc) are accepted.
#!/usr/bin/python

import sys
import pyfits
import re

for file in sys.argv[1:]:  #exclude the first element of sys.argv
     hdulist = pyfits.open(file)  #open fits
     key = hdulist[1].header['OBJECT'] #reads a keyword from the fits header
     if (re.search('standard',key)):  #search the keyword value for some string
             print file
To execute just run on the command line:
# python script.py file1 file2 ...
or
# chmod +x script.py
# ./script.py file1 file2 ...
All bash's wildcards (*, ?, etc) are accepted.
Wednesday, March 3, 2010
How to know how many slots of memory are used (or free)?
My last linux trouble was to discover how many memory slots were free in my CPU without opening it.
The solution to this problem comes from Lamarque Souza:
all you need is to run dmidecode | grep -A 8 'Memory' as root, or on ubuntu:
sudo dmidecode | grep -A 8 'Memory'
Note: For more information remove the -A 8 from the grep command.
If it works correctly you should get something like the below. What you can see is that there are 4 slots for memory, and 2 of them have memory installed ( look at: Memory Device).
Physical Memory Array
Location: System Board Or Motherboard
Use: System Memory
Error Correction Type: None
Maximum Capacity: 8 GB
Error Information Handle: Not Provided
Number Of Devices: 4
Handle 0x0015, DMI type 19, 15 bytes
Memory Array Mapped Address
Starting Address: 0x00000000000
Ending Address: 0x000FFFFFFFF
Range Size: 4 GB
Physical Array Handle: 0x0014
Partition Width: 0
Handle 0x0016, DMI type 17, 27 bytes
Memory Device
Array Handle: 0x0014
Error Information Handle: Not Provided
Total Width: 64 bits
Data Width: 64 bits
Size: 2048 MB
Form Factor: DIMM
Set: None
Locator: J1MY
--
Memory Device
Array Handle: 0x0014
Error Information Handle: Not Provided
Total Width: 64 bits
Data Width: 64 bits
Size: 2048 MB
Form Factor: DIMM
Set: None
Locator: J2MY
--
Memory Device
Array Handle: 0x0014
Error Information Handle: Not Provided
Total Width: Unknown
Data Width: Unknown
Size: No Module Installed
Form Factor: DIMM
Set: None
Locator: J3MY
--
Memory Device
Array Handle: 0x0014
Error Information Handle: Not Provided
Total Width: Unknown
Data Width: Unknown
Size: No Module Installed
Form Factor: DIMM
Set: None
Locator: J4MY
The solution to this problem comes from Lamarque Souza:
all you need is to run dmidecode | grep -A 8 'Memory' as root, or on ubuntu:
sudo dmidecode | grep -A 8 'Memory'
Note: For more information remove the -A 8 from the grep command.
If it works correctly you should get something like the below. What you can see is that there are 4 slots for memory, and 2 of them have memory installed ( look at: Memory Device).
Physical Memory Array
Location: System Board Or Motherboard
Use: System Memory
Error Correction Type: None
Maximum Capacity: 8 GB
Error Information Handle: Not Provided
Number Of Devices: 4
Handle 0x0015, DMI type 19, 15 bytes
Memory Array Mapped Address
Starting Address: 0x00000000000
Ending Address: 0x000FFFFFFFF
Range Size: 4 GB
Physical Array Handle: 0x0014
Partition Width: 0
Handle 0x0016, DMI type 17, 27 bytes
Memory Device
Array Handle: 0x0014
Error Information Handle: Not Provided
Total Width: 64 bits
Data Width: 64 bits
Size: 2048 MB
Form Factor: DIMM
Set: None
Locator: J1MY
--
Memory Device
Array Handle: 0x0014
Error Information Handle: Not Provided
Total Width: 64 bits
Data Width: 64 bits
Size: 2048 MB
Form Factor: DIMM
Set: None
Locator: J2MY
--
Memory Device
Array Handle: 0x0014
Error Information Handle: Not Provided
Total Width: Unknown
Data Width: Unknown
Size: No Module Installed
Form Factor: DIMM
Set: None
Locator: J3MY
--
Memory Device
Array Handle: 0x0014
Error Information Handle: Not Provided
Total Width: Unknown
Data Width: Unknown
Size: No Module Installed
Form Factor: DIMM
Set: None
Locator: J4MY
Friday, February 26, 2010
Inkscape: powerful tool to edit plots and PDF files
The free graphics editor Inkscape is a powerful PDF editor. It can be used to change / enhance figures embedded in PDF documents, without the need of having the source data using to produce the plot.
Suppose there is a given plot in a paper and you want to use it in a talk or another document. Suppose that you would like to change the color of a line, or make the points thicker etc. That is easy with Inkscape. If the plot was embedded in the PDF including vectorial data, then you can change all its properties by opening the PDF file in Inkscape, making the changes (the interface is intuitive) and then exporting it as a PDF, PNG etc.
Inkscape is available for Mac OS X, Linux and Windows.
Suppose there is a given plot in a paper and you want to use it in a talk or another document. Suppose that you would like to change the color of a line, or make the points thicker etc. That is easy with Inkscape. If the plot was embedded in the PDF including vectorial data, then you can change all its properties by opening the PDF file in Inkscape, making the changes (the interface is intuitive) and then exporting it as a PDF, PNG etc.
Inkscape is available for Mac OS X, Linux and Windows.
New colors in SM
I like to use Super Mongo to make my plots. It is a very nice software, but somethings are, some times, hard to do (or hard to find in the tutorial). My last 3 problems were related to:
a) Log scales in SM.
All what you need to do is:
: ticksize -1 0 -1 0
: box
Note: you need to work with the data in log, what you can do by:
: read {f1 1}
: set f1=lg(f1)
b) Add grid lines in the plot.
: box grid 1 (to small and long grid lines) or 0 (for only long grid).
c) The last one was in trying to add more colors to SM color pallet.
To solve this issue I found Annika Peter page, which I resume below.
Note: The figures were taken from Annika Peter page.
The problem: There are only seven "default" colors in SM.

But is very easy to add more colors to SM color pallet.
i) use the command "add_ctype"

I hope this will help you.
a) Log scales in SM.
All what you need to do is:
: ticksize -1 0 -1 0
: box
Note: you need to work with the data in log, what you can do by:
: read {f1 1}
: set f1=lg(f1)
b) Add grid lines in the plot.
: box grid 1 (to small and long grid lines) or 0 (for only long grid).
c) The last one was in trying to add more colors to SM color pallet.
To solve this issue I found Annika Peter page, which I resume below.
Note: The figures were taken from Annika Peter page.
The problem: There are only seven "default" colors in SM.

But is very easy to add more colors to SM color pallet.
i) use the command "add_ctype"
: add_ctype mycolor 170 170 0
This will produce darkgold
A very nice tool to help here is the http://www.colorschemer.com/online.html web site.
A very nice tool to help here is the http://www.colorschemer.com/online.html web site.
ii) Use the : xtcolors to add new colors. This will produce the following colors.

I hope this will help you.
Friday, February 19, 2010
Suggested reading: The trouble with physics by Lee Smolin
 I just devoured this book on my trip to Chile last week. The author, Lee Smolin, gives a very clear description off the main revolutions in physics and explain why and how does the string theory fails as a theory by itself. There are great examples explaining how the great scientist, such as Galileo, Kepler, and Einstein got theirs insights and played important roles in modern science.
This is a book for the layman, although a little bit of basic physics helps to see the big picture more clearly. I recommend it for everyone that is starting a career on physics/astronomy (at least it helped me a lot!).
Monday, February 1, 2010
Using f2py
The purpose of the F2PY --Fortran to Python interface generator-- is to provide connection between Python and Fortran languages. Here I will show a simple example of how to use this tool and compare the its efficiency against a pure python code.
First, lets write our fortran routine:
This code simply calculate the distance to the origin of a bunch of points. The input is two vectors with identical dimension n. Note that you must specify what goes in and what goes out to the f2py parser, this is done by using the a comment line followed by f2py:
Now lets compile and link it to python using:
Unfortunately f2py does not easily support the Intel Fortran Compiler (ifort), although gfortran does a good job on most of the cases.
It ridiculously easy to call this routine inside python. The script bellow call the fortran routine and then compares its execution time with an identical pure python routine plus the same done using Numpy.
If everything goes OK the result should be something like this:
The advantages of using f2py are obvious, the runtime of the pure python code is almost 500 times greater! When using numpy to handle the arrays we get a much better execution time, but still slower when compared to fortran.
I hope this post was useful to the people thinking of migrating to python in the near future.
First, lets write our fortran routine:
        Subroutine test(a,b,n,c)

        Implicit none
        Integer::i
        Integer, intent(in)::n
        Real, dimension(n), intent(in)::a,b
        Real, dimension(n), intent(out)::c
!f2py   depend(n)::a,b,c
!f2py   intent(in)::a,b
!f2py   intent(out)::c

        Do i=1,n
          c(i) = sqrt(a(i)**2.0 + b(i)**2.0)
        EndDo

        End subroutine test
This code simply calculate the distance to the origin of a bunch of points. The input is two vectors with identical dimension n. Note that you must specify what goes in and what goes out to the f2py parser, this is done by using the a comment line followed by f2py:
!f2py   depend(n)::a,b,c
!f2py   intent(in)::a,b
!f2py   intent(out)::c
Now lets compile and link it to python using:
f2py -m func -h func.pyf func.f --overwrite-signature
f2py --fcompiler=gfortran -c func.pyf func.f
Unfortunately f2py does not easily support the Intel Fortran Compiler (ifort), although gfortran does a good job on most of the cases.
It ridiculously easy to call this routine inside python. The script bellow call the fortran routine and then compares its execution time with an identical pure python routine plus the same done using Numpy.
#!/usr/bin/python
import numpy as np
import time
import func

n = 10000
#generates a normal distribution with n points
x = np.random.randn(n)
y = np.random.randn(n)

# Using the fortran routine
t1 = time.time()
f = func.test(x,y,n)
t2 = time.time()

t = (t2-t1)*1000

print 'Fortran runtime (ms): ',t

# Using pure python
t1 = time.time()
r = np.zeros(n)
for i in range(n):
 r[i] = np.sqrt(x[i]**2 + y[i]**2)
t2 = time.time()

t = (t2-t1)*1000

print 'Python runtime (ms): ',t

# Using pure python
t1 = time.time()
r = np.sqrt(x**2 + y**2)
t2 = time.time()
t = (t2-t1)*1000

print 'Python + numpy runtime (ms): ',t
If everything goes OK the result should be something like this:
Fortran runtime (ms):  0.150918960571
Python runtime (ms):  76.4260292053
Python + numpy runtime (ms):  0.485181808472
The advantages of using f2py are obvious, the runtime of the pure python code is almost 500 times greater! When using numpy to handle the arrays we get a much better execution time, but still slower when compared to fortran.
I hope this post was useful to the people thinking of migrating to python in the near future.
Sunday, January 31, 2010
Dropbox: online folder to easily sync your data across different computers
Like many users, I regularly use more than one computer: one at home (a Mac) and one at work (Linux workstation). This kind of situation creates some challenges regarding how to keep your data synchronized between the different computers/operating systems.
That's where the free online service Dropbox comes handy. It creates a local folder called Dropbox in your "home". Everything that you dump in that folder is automatically synced with the online folder, and immediately made available to all your computers. You just need to install a dropbox client in each computer, and that's it. Thanks to Dropbox, I almost don't need to use USB flash drives anymore to sync data between different computers. Sweet!
Dropbox has a cool feature: it lets you share a folder among a group of people. Let me give an example of how that can be useful. Suppose you have coworkers/collaborators and you are working together on some code, paper or data. Suppose that you are constantly updating your code/paper/data and your collaborator wants to always have the latest version of it. When you share a dropbox folder with your collaborators, every change that you or your coworker make to any file in that folder is automatically made available to all the people sharing the folder. See how the sharing feature can be useful?
Dropbox gives you a free 2 GB account. For paid accounts, they provide more space (up to 100 GB).
Link to join Dropbox (includes a tour of the features).
Changelog:
That's where the free online service Dropbox comes handy. It creates a local folder called Dropbox in your "home". Everything that you dump in that folder is automatically synced with the online folder, and immediately made available to all your computers. You just need to install a dropbox client in each computer, and that's it. Thanks to Dropbox, I almost don't need to use USB flash drives anymore to sync data between different computers. Sweet!
Dropbox has a cool feature: it lets you share a folder among a group of people. Let me give an example of how that can be useful. Suppose you have coworkers/collaborators and you are working together on some code, paper or data. Suppose that you are constantly updating your code/paper/data and your collaborator wants to always have the latest version of it. When you share a dropbox folder with your collaborators, every change that you or your coworker make to any file in that folder is automatically made available to all the people sharing the folder. See how the sharing feature can be useful?
Dropbox gives you a free 2 GB account. For paid accounts, they provide more space (up to 100 GB).
Link to join Dropbox (includes a tour of the features).
Changelog:
- May 31 2010: Added "sharing" feature.
Saturday, January 30, 2010
Syntax Highlight
Testando os scripts de syntax highlight do blogger
Funciona! Então, pra usar é só só escrever o código entre as tags PRE usando os modificadores name='code' e class='linguagem'. Por enquanto linguagem pode ser: C, C#, CSS, Bash, Java, JavaScript, Perl, PHP, Python, Ruby e Sql
Qualquer dúvida dá uma espiada no código fonte desse post.
Ah sim, o script ali é para converter qualquer formato em qualquer formato todos os arquivos de um diretório. Usa o comando a2ping e transforma, nesse caso, qualquer formato para png (Portable network graphs).
#!/bin/bash
# converte qq formato para qq formato (muhahahaha!)

for file in $1/*
do
    ext=$(echo $file | sed 's/.*\([^\.]\+\)\.\([^\.]\+\)$/\2/')
    name=$(basename $file .$ext) #elimina $ext do nome
    a2ping $file png:$name.png --nocompress --papersize=unchanged

done
Funciona! Então, pra usar é só só escrever o código entre as tags PRE usando os modificadores name='code' e class='linguagem'. Por enquanto linguagem pode ser: C, C#, CSS, Bash, Java, JavaScript, Perl, PHP, Python, Ruby e Sql
Qualquer dúvida dá uma espiada no código fonte desse post.
Ah sim, o script ali é para converter qualquer formato em qualquer formato todos os arquivos de um diretório. Usa o comando a2ping e transforma, nesse caso, qualquer formato para png (Portable network graphs).
Thursday, January 28, 2010
Vim Tip: como comentar multiplas linhas?
Isso é muito útil na hora de mascarar um bloco de código comentando-o.
Para fazer isso basta entrar no modo visual do vi (CTRL + I) na primeira linha que deseja comentar. Vá até a ultima linha que deseja comentar e aperte I (Letra I maiúscula; insere no começo da linha) e insira o caractere de comentário (#: python,bash ; !: fortran; %: latex ...) e em seguida aperte ESC para sair do modo visual.
Simples, não? X é para os fracos.
Obs.: Para descomentar, no modo visual selecione a primeira coluna e aperte x.
Para fazer isso basta entrar no modo visual do vi (CTRL + I) na primeira linha que deseja comentar. Vá até a ultima linha que deseja comentar e aperte I (Letra I maiúscula; insere no começo da linha) e insira o caractere de comentário (#: python,bash ; !: fortran; %: latex ...) e em seguida aperte ESC para sair do modo visual.
Simples, não? X é para os fracos.
Obs.: Para descomentar, no modo visual selecione a primeira coluna e aperte x.
Wednesday, January 27, 2010
Mais Python?
Só pra mostrar que eu faço alguma coisa da vida, ai vai mais um post com um tutorial em python.
Agora vou mostrar como interagir com gráficos. Isso na verdade é bastante complicado, requer um entendimento forte de orientação a objetos(OO). Nesse exemplo eu tentei evitar OO, justamente porque não estou tão familiarizado com isso.
A proposta é: dado um conjunto de pontos como selecionar somente aqueles dentro de um polígono definido pelo usuário interagindo com o gráfico? A solução é o seguinte a seguir. Como de costume, precisa o NumPy, MatPlotLib e PyLab.
O programa funciona da seguinte maneira. Enquanto você vai com o mouse no ponto onde quer definir um dos vértices do polígono e aperta alguma tecla do teclado que não seja a tecla 'q', um ponto será marcado. Ao apertar 'q' você sai do programa e os pontos dentro do polígono são marcados pela cor vermelha.
Felizmente, nesse exemplo não precisa baixar nada. Basta copiar, colar e rodar. Ah sim, o highlight da sintaxe python foi feito nesse site.
Ia escrever outro post sobre um resolvedor de simulação 3 corpos em python, mas já ta no meu site e eu cansei do blogspot, queria mesmo é o wordpress. Nesse exemplo tem até instruções pra criar uma animação.
PS.: caiu fora do post as linhas muito longas, não to com saco pra arrumar agora
Agora vou mostrar como interagir com gráficos. Isso na verdade é bastante complicado, requer um entendimento forte de orientação a objetos(OO). Nesse exemplo eu tentei evitar OO, justamente porque não estou tão familiarizado com isso.
A proposta é: dado um conjunto de pontos como selecionar somente aqueles dentro de um polígono definido pelo usuário interagindo com o gráfico? A solução é o seguinte a seguir. Como de costume, precisa o NumPy, MatPlotLib e PyLab.
O programa funciona da seguinte maneira. Enquanto você vai com o mouse no ponto onde quer definir um dos vértices do polígono e aperta alguma tecla do teclado que não seja a tecla 'q', um ponto será marcado. Ao apertar 'q' você sai do programa e os pontos dentro do polígono são marcados pela cor vermelha.
#!/usr/bin/python
from pylab import *
import numpy as np
import matplotlib.nxutils as nx

poly=np.zeros([100,2]) #limits the number of vertices to 100 (how to ovecome this?)
i = int(0)             #not very python-ish
x = np.random.rand(1000)
y = np.random.rand(1000)
f = np.array([x,y])
f = np.transpose(f)

def click(event):
    global poly,f,i,g
    tb = get_current_fig_manager().toolbar
    if event.key != 'q' and event.inaxes and tb.mode == '':
      poly[i,0],poly[i,1] = event.xdata,event.ydata
      plot(poly[0:i+1,0],poly[0:i+1,1],'rs-')
      draw()
      i += 1
    else:
      poly[i,0],poly[i,1] = poly[0,0],poly[0,1]
      poly = np.resize(poly,(i+1,2))
      inside = nx.points_inside_poly(f[:,0:2], poly)
      g = f[nonzero(inside),]   #this adds an extra dimension to the array (why?!)
      plot(g[:,:,0],g[:,:,1],'r.',markersize=6)
      return g

fig = figure()
ax = fig.add_subplot(111,autoscale_on=True)
ax.plot(f[:,0],f[:,1],'k.',markersize=4)

#connects python with the display
cid = connect('key_press_event', click)
show()
disconnect(cid)
Felizmente, nesse exemplo não precisa baixar nada. Basta copiar, colar e rodar. Ah sim, o highlight da sintaxe python foi feito nesse site.
Ia escrever outro post sobre um resolvedor de simulação 3 corpos em python, mas já ta no meu site e eu cansei do blogspot, queria mesmo é o wordpress. Nesse exemplo tem até instruções pra criar uma animação.
PS.: caiu fora do post as linhas muito longas, não to com saco pra arrumar agora
Python \o/
Então, nas ultimas semanas estive envolvido com Python bastante. O motivo disso é que o Dark Energy Survey (DES) adota o python como sua linguagem de frontend. Como eu faço parte do grupo de populações estelares do DES fui obrigado a lidar com Python em diversos níveis. Então vou explicar uma das coisas que tive que desenvolver nesse projeto.
O objetivo desse tuturial é gerar uma carta do céu e identificar certas estrelas nesta carta. O propósito é o planejamento de uma observação astronômica, nesse caso do aglomerado globular NGC 2298. Com essa carta o observador vai saber se o telescópio está apontando na direção que deveria estar apontando. O campo é uma simulação do campo de visão do instrumento MOSAIC2 do telescópio Blanco de 4m.
Bom, vamos ao Python... Para rodar esse programa você vai precisar dos módulos NumPy e PyLab, ambos disponíveis através do repositório Debian/Ubuntu e do módulo APLpy que deve ser instalado manualmente. Além disso para rodar você precisa baixar e descompactar os arquivos específicos para esse problema aqui.
O produto final, se tudo der certo, deve ser algo do tipo:
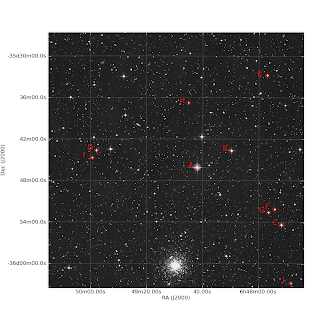
O objetivo desse tuturial é gerar uma carta do céu e identificar certas estrelas nesta carta. O propósito é o planejamento de uma observação astronômica, nesse caso do aglomerado globular NGC 2298. Com essa carta o observador vai saber se o telescópio está apontando na direção que deveria estar apontando. O campo é uma simulação do campo de visão do instrumento MOSAIC2 do telescópio Blanco de 4m.
Bom, vamos ao Python... Para rodar esse programa você vai precisar dos módulos NumPy e PyLab, ambos disponíveis através do repositório Debian/Ubuntu e do módulo APLpy que deve ser instalado manualmente. Além disso para rodar você precisa baixar e descompactar os arquivos específicos para esse problema aqui.
O produto final, se tudo der certo, deve ser algo do tipo:

#!/usr/bin/python
from pylab import *
import aplpy
import numpy as np

Alphabet = map(chr, range(65, 91))   # Capitalized alphabet

fig = figure(figsize=(10,10))
gc = aplpy.FITSFigure('field.fits',figure=fig, subplot=[0.15,0.1,0.8,0.8])
gc.show_grayscale()
gc.show_grid()
gc.set_grid_alpha(0.2)

# read and plot the GSC stars
f = np.loadtxt('gsc.dat')
ra,dec = f[:,0],f[:,1]
gc.show_markers(ra,dec,edgecolor='red',marker='o',s=50)

#this convert from world coordinates to pixel (canvas) coordinates
newra,newdec = gc.world2pixel(ra+0.025,dec)

#place a tag near each marked point in the image
for i in range(f.shape[0]):
  text(newra[i],newdec[i],Alphabet[i],fontsize=16,color='red')

#save as png
gc.save('findingchart.png')
Monday, January 18, 2010
Easy ways of adding math/greek in your IDL plots
It's not straightforward to add greek letters, math etc in IDL plots. Fortunately, there are some libraries that make our life easier for this purpose:
TeXtoIDL
The purpose of the TeXtoIDL routines is to make it simple to use Greek letters, subscripts and superscripts in making labels for plots in IDL. This is accomplished by allowing the user to use TeX control sequences for Greek letters and special symbols and for sub/superscripts.
Example:
The command below uses textoidl to create a somewhat fancy X label.
IDL > plot, [0], [0], xtitle=textoidl("\rho^2 + 2\Gamma_{ij}")
Greek (Coyote Library)
Another way of inserting greek letters in your plots. The command greek('mu') for example returns a string with the greek letter mu.
Example:
TeXtoIDL
The purpose of the TeXtoIDL routines is to make it simple to use Greek letters, subscripts and superscripts in making labels for plots in IDL. This is accomplished by allowing the user to use TeX control sequences for Greek letters and special symbols and for sub/superscripts.
Example:
The command below uses textoidl to create a somewhat fancy X label.
IDL > plot, [0], [0], xtitle=textoidl("\rho^2 + 2\Gamma_{ij}")
Greek (Coyote Library)
Another way of inserting greek letters in your plots. The command greek('mu') for example returns a string with the greek letter mu.
Example:
IDL > Plot, [0], [0], XTitle='Wavelength (' + Greek('mu') + 'm)'
Wednesday, January 6, 2010
Gerencie seus artigos com MENDELEY
Olá pessoal,
Venho usando a algum tempo um programa chamado "MENDELEY" para organizar e gerenciar os artigos (em pdf) baixados do ADS, AstroPH, etc. É um programa extremamente útil, inteligente e fácil de usar (e, claro, gratuíto e roda no Linux e em outros OS's). Diria que é "A" ferramenta!
Este programa vem sendo usado cada vez em escala crescente no meio científico e veio preencher
uma lacuna que existia no universo dos aplicativos voltados para pesquisadores. Possivelmente,
nos próximos anos, será uma ferramenta que grande parte dos pesquisadores estará usando.
O intuito desta mensagem é divulgar (para quem não conhece ainda) e incentivar o uso do MENDELEY no DepAstro.
Funciona assim: vc cria um diretório e coloca lá todos os PDFs que baixou (ou gerou) nos últimos 200 anos. Colocará lá também todos os PDFs que baixar (ou gerar) nos próximos 200 anos.
Depois de baixar e instalar o MENDELEY, deve configurá-lo (isso é fácil!) para procurar seus
artigos pdfs neste diretório. Na primeira vez que ele rodar, vai ler cada artigo PDF e extrair automaticamente informações como título, autores, ano de publicação, nome do periódico, página, ref, etc. Tudo isso vai para um banco de dados que vc poderá consultar de modo fácil e prático a qualquer momento. Cada autor, por exemplo, vai para uma lista de autores; depois, basta clicar no nome de um autor para ele listar todos os artigos disponíveis com este autor.
Vc não precisa se preocupar mais com as atualizações de seu banco de dados. Cada novo artigo que baixar da internet, basta jogar nesse diretório e o MENDELEY, automaciamente, se encarregará em incluí-lo em seu banco de dados (ele espia o diretório periodicamente a procura de novidades). Apenas jogue seus pdfs no diretório e deixe o resto com o MENDELEY.
Os artigos podem ser agrupados em CATEGORIAS (através de Tags), definidas pelo usuário.
O programa permite BUSCAS por palavras chaves ou expressões nos textos e muito mais:
ele dispõe de uma CANETA VITURAL MARCADORA DE TEXTO, com a qual vc pode marcar em amarelo partes do texto (como faria com uma caneta marcadora real!).
Também pode inserir POST IT's (aqueles papeis amerelos), virtuais, com seus comentários em diferente partes do texto. Estes recursos são extremamente úteis para REFEREES ou para inserir comentários no artigo de um colaborador (ou em qualquer outro doc pdf, como teses, dissertações, ebooks, etc), ou em um artigo em preparação.
Os recursos do programa não param por aí: vc pode PARTILHAR ARTIGOS através da internet (enviar / receber / acessar) com seus colegas de grupo (e de outras instituições dentro e fora do país) que também usam o MENDELEY. Algo como o velho Napster, LimeWare ou Kaza, só que para artigos. Atualmente (jan/2010) já existe mais de 210 milhões de referências nos bancos de dados dos ~13 mil usuários espalhados pelo mundo. Essa é uma das boas razões para incentivar o uso deste programa em maior escala entre nós. Não vai mais precisar enviar artigos por email.
Outra coisa que ele faz é GERAR BIBLIOGRAFIAS em BiBTeX ou similares a partir de uma
lista de artigos pré-selecionados. Útil para quem está escrevendo um artigo, tese ou dissertação.
Isso é só para citar algumas das habilitades do bicho.
Claro que há deficiências: p.ex, o MENDELEY consegue extrair informações muito bem dos artigos mais recentes (de ~10 anos para cá) que foram gerados diretamente no formato pdf, MAS, se atrapalha todo com artigos mais antigos, que foram escaneados ou convertidos para PDF a partir de algum outro formato (jpg, gif, png, ps, etc). Para estes vc tem que editar as informações manualmente, mas os 1 ou 2 minutos que se gasta fazendo isso são plenamente compensados por todos os benefícios que o programa oferece.
O programa vem sendo continuamente aperfeiçoado e o usuário não precisa se preocupar com
as ATUALIZAÇÕES: elas são feitas automaticamente!
O site para download é: http://www.mendeley.com/
Enjoy it.
Edu
Venho usando a algum tempo um programa chamado "MENDELEY" para organizar e gerenciar os artigos (em pdf) baixados do ADS, AstroPH, etc. É um programa extremamente útil, inteligente e fácil de usar (e, claro, gratuíto e roda no Linux e em outros OS's). Diria que é "A" ferramenta!
Este programa vem sendo usado cada vez em escala crescente no meio científico e veio preencher
uma lacuna que existia no universo dos aplicativos voltados para pesquisadores. Possivelmente,
nos próximos anos, será uma ferramenta que grande parte dos pesquisadores estará usando.
O intuito desta mensagem é divulgar (para quem não conhece ainda) e incentivar o uso do MENDELEY no DepAstro.
Funciona assim: vc cria um diretório e coloca lá todos os PDFs que baixou (ou gerou) nos últimos 200 anos. Colocará lá também todos os PDFs que baixar (ou gerar) nos próximos 200 anos.
Depois de baixar e instalar o MENDELEY, deve configurá-lo (isso é fácil!) para procurar seus
artigos pdfs neste diretório. Na primeira vez que ele rodar, vai ler cada artigo PDF e extrair automaticamente informações como título, autores, ano de publicação, nome do periódico, página, ref, etc. Tudo isso vai para um banco de dados que vc poderá consultar de modo fácil e prático a qualquer momento. Cada autor, por exemplo, vai para uma lista de autores; depois, basta clicar no nome de um autor para ele listar todos os artigos disponíveis com este autor.
Vc não precisa se preocupar mais com as atualizações de seu banco de dados. Cada novo artigo que baixar da internet, basta jogar nesse diretório e o MENDELEY, automaciamente, se encarregará em incluí-lo em seu banco de dados (ele espia o diretório periodicamente a procura de novidades). Apenas jogue seus pdfs no diretório e deixe o resto com o MENDELEY.
Os artigos podem ser agrupados em CATEGORIAS (através de Tags), definidas pelo usuário.
O programa permite BUSCAS por palavras chaves ou expressões nos textos e muito mais:
ele dispõe de uma CANETA VITURAL MARCADORA DE TEXTO, com a qual vc pode marcar em amarelo partes do texto (como faria com uma caneta marcadora real!).
Também pode inserir POST IT's (aqueles papeis amerelos), virtuais, com seus comentários em diferente partes do texto. Estes recursos são extremamente úteis para REFEREES ou para inserir comentários no artigo de um colaborador (ou em qualquer outro doc pdf, como teses, dissertações, ebooks, etc), ou em um artigo em preparação.
Os recursos do programa não param por aí: vc pode PARTILHAR ARTIGOS através da internet (enviar / receber / acessar) com seus colegas de grupo (e de outras instituições dentro e fora do país) que também usam o MENDELEY. Algo como o velho Napster, LimeWare ou Kaza, só que para artigos. Atualmente (jan/2010) já existe mais de 210 milhões de referências nos bancos de dados dos ~13 mil usuários espalhados pelo mundo. Essa é uma das boas razões para incentivar o uso deste programa em maior escala entre nós. Não vai mais precisar enviar artigos por email.
Outra coisa que ele faz é GERAR BIBLIOGRAFIAS em BiBTeX ou similares a partir de uma
lista de artigos pré-selecionados. Útil para quem está escrevendo um artigo, tese ou dissertação.
Isso é só para citar algumas das habilitades do bicho.
Claro que há deficiências: p.ex, o MENDELEY consegue extrair informações muito bem dos artigos mais recentes (de ~10 anos para cá) que foram gerados diretamente no formato pdf, MAS, se atrapalha todo com artigos mais antigos, que foram escaneados ou convertidos para PDF a partir de algum outro formato (jpg, gif, png, ps, etc). Para estes vc tem que editar as informações manualmente, mas os 1 ou 2 minutos que se gasta fazendo isso são plenamente compensados por todos os benefícios que o programa oferece.
O programa vem sendo continuamente aperfeiçoado e o usuário não precisa se preocupar com
as ATUALIZAÇÕES: elas são feitas automaticamente!
O site para download é: http://www.mendeley.com/
Enjoy it.
Edu
Tuesday, December 1, 2009
Recovering data points using g3data
A very nice free, (GNU GPL) application that can be used for extracting data from graphs is g3data. You can install it in ubuntu by typing:
$ sudo apt-get install g3data
or simply download it from the g3data website http://www.frantz.fi/software/g3data.php
I have used it a few times in the past on graphs of different kind and quality and always obtained good results for the extracted data points using it.
The following picture shows g3data at work on a plot:

When the data are recovered you can store them in a file and use your favorite tool to create a new plot.
$ sudo apt-get install g3data
or simply download it from the g3data website http://www.frantz.fi/software/g3data.php
I have used it a few times in the past on graphs of different kind and quality and always obtained good results for the extracted data points using it.
The following picture shows g3data at work on a plot:

Wednesday, November 11, 2009
Recovering deleted pictures from a memory card
A friend of mine recently deleted by accident around 700 pictures from a memory card in her Sony digital camera. She asked for my help and I thought that it would be an easy task to recover the pictures. I played with different programs aimed at data recovery, some of them tuned specifically for photo recovery. Here is a description of the different programs that I used and the results.
I've got several suggestions from colleagues of recovery software to try in linux and windows. I also found that this list of free data recovery programs at lifehacker was very useful.
This tutorial assumes that the memory card is formatted with the filesystem FAT16 (default filesystem in memory cards). The first thing you need to avoid is to write any data to the device where the deleted files were stored.
You should create an image of the device as soon as possible, in case anything goes wrong. In Linux that is pretty easy. Assuming that the memory card is mounted as /dev/sdb1, you need to issue the command
sudo dd if=/dev/sdb1 of=backupcard.img
I tried the following free software (ordered according to my taste): Recuva (win), recoverjpeg (linux/mac) and PhotoRec (win/linux/mac) (recoverjpeg and PhotoRec are available in Ubuntu via Synaptic). I also tried the commercial alternatives Stellar Phoenix Recovery (win) and Nucleus Kernel FAT (win). The latter two programs gave the same results as the three free programs listed above, so no need to pay for them.
The first program I tried was Recuva. It immediately recovered all the deleted files. Unfortunately most of the recovered pictures were corrupted or broken. By corrupted I mean that the pictures have one or more of the following "features":
recoverjpeg gave the same results as Recuva: restored all the photos, but only ~1/7 of the original files were successfully recovered with no problems.
PhotoRec only recovered the ~1/7 pictures that had no problems, ignoring the other corrupted files.
My conclusion: if you use windows try Recuva. If you are a Linux user, try recoverjpeg. And please check this list of Five best free data recovery tools.
I've got several suggestions from colleagues of recovery software to try in linux and windows. I also found that this list of free data recovery programs at lifehacker was very useful.
This tutorial assumes that the memory card is formatted with the filesystem FAT16 (default filesystem in memory cards). The first thing you need to avoid is to write any data to the device where the deleted files were stored.
You should create an image of the device as soon as possible, in case anything goes wrong. In Linux that is pretty easy. Assuming that the memory card is mounted as /dev/sdb1, you need to issue the command
sudo dd if=/dev/sdb1 of=backupcard.img
I tried the following free software (ordered according to my taste): Recuva (win), recoverjpeg (linux/mac) and PhotoRec (win/linux/mac) (recoverjpeg and PhotoRec are available in Ubuntu via Synaptic). I also tried the commercial alternatives Stellar Phoenix Recovery (win) and Nucleus Kernel FAT (win). The latter two programs gave the same results as the three free programs listed above, so no need to pay for them.
The first program I tried was Recuva. It immediately recovered all the deleted files. Unfortunately most of the recovered pictures were corrupted or broken. By corrupted I mean that the pictures have one or more of the following "features":
- Pictures split in two or more parts
- In between a picture there is part of another photo
- Colors changed
recoverjpeg gave the same results as Recuva: restored all the photos, but only ~1/7 of the original files were successfully recovered with no problems.
PhotoRec only recovered the ~1/7 pictures that had no problems, ignoring the other corrupted files.
My conclusion: if you use windows try Recuva. If you are a Linux user, try recoverjpeg. And please check this list of Five best free data recovery tools.
Friday, October 30, 2009
The International Astronomy Meetings List
This link lists the astronomy meetings that will happen around the world: The International Astronomy Meetings List.
Pretty nice.
Pretty nice.
Monday, October 19, 2009
The IFU wiki
To the IFU people: The Integral Field Spectroscopy Wiki
"Do you currently work with, or are you thinking about applying for
integral field unit (IFU) observations? If so, then the Integral Field
Spectroscopy wiki is for you."
(via AstroBetter)
"Do you currently work with, or are you thinking about applying for
integral field unit (IFU) observations? If so, then the Integral Field
Spectroscopy wiki is for you."
(via AstroBetter)
Making your linux desktop more useful (and prettier)
Here is a list of things that I implemented in my Linux desktop manager (Gnome), and made it more productive and also prettier. By prettier I mean looking more like Mac OS X. So in fact this guide gives suggestions to make your linux desktop become more like Mac OS X.
Disclaimer: Some of the suggestions are suited for Gnome, which is the desktop manager that I use. My distro is Ubuntu.Why do I pick Gnome? Well, because I don't like KDE and because Gnome looks more like Mac OS X.
First of all, you need Compiz to turn on pretty 3D effects. And in order to have compiz working you need decent drivers for your video board, with support for 3D acceleration. I suggest to install the package compizconfig-settings-manager which provides a nice interface for changing the settings of the different compiz plugins.
The compiz plugins that I find most useful are:
Google Desktop for linux is a fantastic desktop search tool. It allows me to open the papers and documents I want incredibly fast, without needing to browse any folder. Just need to press CTRL twice and type the relevant keywords. It is the analogous of Mac's Spotlight.
For quickly opening applications, try Gnome-Do. It is the equivalent of Mac's Quicksilver. Again, no need to browse menus for the application you need. Just call gnome-do and type in the few beginning letters in the name of the program you want to launch.
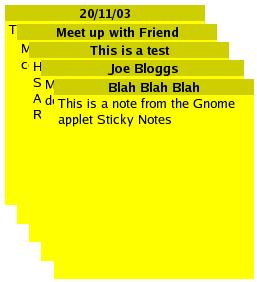
For to-do lists and reminders, try the Sticky Notes applet that comes built-in with Gnome.
Any other suggestions? Feel free to comment.
Disclaimer: Some of the suggestions are suited for Gnome, which is the desktop manager that I use. My distro is Ubuntu.Why do I pick Gnome? Well, because I don't like KDE and because Gnome looks more like Mac OS X.
First of all, you need Compiz to turn on pretty 3D effects. And in order to have compiz working you need decent drivers for your video board, with support for 3D acceleration. I suggest to install the package compizconfig-settings-manager which provides a nice interface for changing the settings of the different compiz plugins.
The compiz plugins that I find most useful are:
- Desktop Wall, for switching between virtual desktops or viewports
- Expo, which shows a snapshot of all desktops at once, similarly to Mac's Spaces
- Scale provides the same functionality as Mac's Exposé
Google Desktop for linux is a fantastic desktop search tool. It allows me to open the papers and documents I want incredibly fast, without needing to browse any folder. Just need to press CTRL twice and type the relevant keywords. It is the analogous of Mac's Spotlight.
For quickly opening applications, try Gnome-Do. It is the equivalent of Mac's Quicksilver. Again, no need to browse menus for the application you need. Just call gnome-do and type in the few beginning letters in the name of the program you want to launch.
For to-do lists and reminders, try the Sticky Notes applet that comes built-in with Gnome.
Any other suggestions? Feel free to comment.
Thursday, October 15, 2009
Tutoriais sobre linux
Este post contém um material que enviei para algumas pessoas que estão iniciando no uso do linux. Pode ser útil aos usuários iniciantes.
Alguns comandos muito úteis no terminal do linux
TAB auto-completa comandos ou nomes de arquivos/diretórios
~ apelido para o caminho da tua home (exemplo: "cd ~" volta para a home)
whatis comando explica sucintamente pra que serve o comando
man comando manual do comando
whereis comando caminho onde está o programa responsável por comando
pwd mostra o caminho completo do diretório corrente
Tabelas de consulta rápida aos comandos
Printable beginner's guide to the terminal
Practical reference of linux commands
Páginas de referência (mais longas)
Guia Foca de Linux
Ubuntu pocket guide and reference (livro completo, grátis)
Linux tutorial for beginners
Alguém tem sugestões sobre bons livros para usuários iniciantes do linux/ubuntu? Escrevam nos comentários.
Alguns comandos muito úteis no terminal do linux
TAB auto-completa comandos ou nomes de arquivos/diretórios
~ apelido para o caminho da tua home (exemplo: "cd ~" volta para a home)
whatis comando explica sucintamente pra que serve o comando
man comando manual do comando
whereis comando caminho onde está o programa responsável por comando
pwd mostra o caminho completo do diretório corrente
Tabelas de consulta rápida aos comandos
Printable beginner's guide to the terminal
Practical reference of linux commands
Páginas de referência (mais longas)
Guia Foca de Linux
Ubuntu pocket guide and reference (livro completo, grátis)
Linux tutorial for beginners
Alguém tem sugestões sobre bons livros para usuários iniciantes do linux/ubuntu? Escrevam nos comentários.
Monday, October 12, 2009
Programas equivalentes: linux e windows
Pessoal,
Achei este link que traz um post muito legal discutindo programas equivalentes em linux e windows.
Isso será útil para novos usuário.
Achei este link que traz um post muito legal discutindo programas equivalentes em linux e windows.
Isso será útil para novos usuário.
Monday, October 5, 2009
TexMaker
Estive com problemas no uso do kile (editor de latex) no gnome. Uma boa alternativa é o texmaker, que roda muito bem no gnome e tem funcionalidades similares as do kile.
IDL for astronomers
I found an interesting blog entry that summarizes the basics of IDL for scientists. I personally think that IDL is much superior, regarding its resources for data analysis and plotting, than programs like Supermongo, Xmgrace (and its flavors), gnuplot and even Origin. The shortcoming is that IDL is not free and quite expensive, but you get what you pay for. I am curious though to learn how Python, supplemented with additional libraries, compares to IDL in this respect.
If you want to learn more about IDL, google for "idl tutorials" and check this guide of IDL for astronomers. The documentation (tutorials) included with IDL are also a nice way to start learning.
In addition, there are some pretty useful IDL libraries for astronomy that I listed.
Nota: a partir de agora vou passar a escrever alguns dos meus posts em inglês. Assim, algumas das informações compartilhadas neste blog poderão ser de utilidade a uma comunidade mais ampla.
If you want to learn more about IDL, google for "idl tutorials" and check this guide of IDL for astronomers. The documentation (tutorials) included with IDL are also a nice way to start learning.
In addition, there are some pretty useful IDL libraries for astronomy that I listed.
Nota: a partir de agora vou passar a escrever alguns dos meus posts em inglês. Assim, algumas das informações compartilhadas neste blog poderão ser de utilidade a uma comunidade mais ampla.
Saturday, October 3, 2009
Solved: Gemini PIT does not work in Ubuntu Linux (recent versions)
Some people noticed that the Gemini PIT (phase I tool) does not work well with some of the most recent versions of Ubuntu linux. What happens: you try to run PIT, but is welcomed by a blank window.
I found out that this problem happens because PIT is not compatible with the resource Compiz available in the most recent versions of linux. The goal of compiz is to make your desktop prettier, looking more like a Mac OS X. The solution is to temporarily disable compiz while you have to submit your observation proposal using PIT.
To temporarily disable compiz, there are two ways that occur to me:
1. In Gnome: System -> preferences -> appearance -> visual effects, set none.
2. Use the program Compiz-switch, which is what I did.
The same trick also works for the Observing Tool (Gemini OT) program.
I found out that this problem happens because PIT is not compatible with the resource Compiz available in the most recent versions of linux. The goal of compiz is to make your desktop prettier, looking more like a Mac OS X. The solution is to temporarily disable compiz while you have to submit your observation proposal using PIT.
To temporarily disable compiz, there are two ways that occur to me:
1. In Gnome: System -> preferences -> appearance -> visual effects, set none.
2. Use the program Compiz-switch, which is what I did.
The same trick also works for the Observing Tool (Gemini OT) program.
Wednesday, September 30, 2009
Solucionado: Gemini PIT não funciona no Ubuntu Linux (versões mais recentes)
Algumas pessoas que estão encaminhando pedidos de tempo com o Gemini notaram que o Gemini PIT (phase I tool) não se entende bem com as versões mais recentes do Ubuntu. O que acontece: você tenta rodar o PIT, mas é agraciado com uma janela em branco.
Descobri que este problema ocorre pois o PIT é incompatível com o recurso Compiz presente nas versões mais recentes do linux, que serve pra deixar o sistema mais bonito. A solução é desativar temporariamente o compiz enquanto você tem que usar o PIT.
Pra desativar temporariamente o compiz há duas maneiras que me ocorrem:
1. No Gnome: System -> preferences -> appearance -> visual effects e botar none.
2. Usar o programa Compiz-switch, que foi o que eu fiz.
Descobri que este problema ocorre pois o PIT é incompatível com o recurso Compiz presente nas versões mais recentes do linux, que serve pra deixar o sistema mais bonito. A solução é desativar temporariamente o compiz enquanto você tem que usar o PIT.
Pra desativar temporariamente o compiz há duas maneiras que me ocorrem:
1. No Gnome: System -> preferences -> appearance -> visual effects e botar none.
2. Usar o programa Compiz-switch, que foi o que eu fiz.
Tuesday, September 29, 2009
Como salvar a lista de pacotes no ubuntu e usar ela para re-instalação posterior.
Várias vezes passamos pelo problema de querer ter duas máquinas com a mesma instalação do linux (ubuntu, no caso) ou de simplesmente recuperar a instalação padrão anterior.
Para isso rode o comando:
sudo dpkg --get-selections | grep -v deinstall > packagelist
Esse comando salvará o nome de todos os pacotes instalados no arquivo packagelist.
Depois abra o synaptic, com o comando:
sudo synaptic
Agora, vá em file depois em read markings e selecione o arquivo packagelist e pronto, é só clicar em instalar.
Espero que estas dicas sejam úteis.
Segue abaixo uma descrição do problema e de soluções "alternativas" a esta.
fonte: http://www.inportb.com/wp/
___________________________________________________________________
HOW TO: on Ubuntu, save the package list and use it to
reinstall packages later
(This tutorial will work for any Debian-based system,
including Ubuntu.)
Have you ever wanted to save a list of software
installed on a Debian box and reinstall the same
packages after reinstalling Debian? Have you ever
wanted to install on a Debian box the same software
you have installed on another Debian box? I've
recently had to reinstall my system from scratch, and
the following may help you as well.
(This is also posted on my blog at
http://www.inportb.com/wp/)
Generate the Package List
Let's first save the current package selection states:
Quote
$ dpkg --get-selections | grep -v deinstall > packagelist
Now we have a compact list of installed packages in a
file called "packagelist". Let's store this so that we
could retrieve it from our other Debian installation.
Or we could email it to ourselves using mailx:
Quote
$ cat packagelist | mailx -s "packagelist" user@example.com
Reinstall the Packages
To restore our packages, let's first restore the
package selection states:
Quote
$ sudo apt-get update
$ sudo apt-get dist-upgrade
$ sudo dpkg --set-selections < packagelist
Now let's actually install it all:
Quote
$ sudo apt-get -u dselect-upgrade
Restore the System
What if we wanted to restore our system to an earlier
state by installing everything that's on our list and
uninstalling everything that's not? We can do that
too, but we need to be careful because this may entail
a radical change. Before restoring our package
selection states, we're going to deselect every
package, thereby marking them for uninstallation:
Quote
$ sudo dpkg --clear-selections
$ sudo dpkg --set-selections < packagelist
Now, every package not on our list has been deselected
and everything on our list has been selected. Let's
commit the changes:
Quote
$ sudo apt-get -u dselect-upgrade
If we wanted to remove the configuration files of the
uninstalled packages, we'd do the following instead:
Quote
$ sudo apt-get -u dselect-upgrade --purge
Please don't forget to restore the package selection
states before running apt-get, or the whole system
would be uninstalled!
Para isso rode o comando:
sudo dpkg --get-selections | grep -v deinstall > packagelist
Esse comando salvará o nome de todos os pacotes instalados no arquivo packagelist.
Depois abra o synaptic, com o comando:
sudo synaptic
Agora, vá em file depois em read markings e selecione o arquivo packagelist e pronto, é só clicar em instalar.
Espero que estas dicas sejam úteis.
Segue abaixo uma descrição do problema e de soluções "alternativas" a esta.
fonte: http://www.inportb.com/wp/
___________________________________________________________________
HOW TO: on Ubuntu, save the package list and use it to
reinstall packages later
(This tutorial will work for any Debian-based system,
including Ubuntu.)
Have you ever wanted to save a list of software
installed on a Debian box and reinstall the same
packages after reinstalling Debian? Have you ever
wanted to install on a Debian box the same software
you have installed on another Debian box? I've
recently had to reinstall my system from scratch, and
the following may help you as well.
(This is also posted on my blog at
http://www.inportb.com/wp/)
Generate the Package List
Let's first save the current package selection states:
Quote
$ dpkg --get-selections | grep -v deinstall > packagelist
Now we have a compact list of installed packages in a
file called "packagelist". Let's store this so that we
could retrieve it from our other Debian installation.
Or we could email it to ourselves using mailx:
Quote
$ cat packagelist | mailx -s "packagelist" user@example.com
Reinstall the Packages
To restore our packages, let's first restore the
package selection states:
Quote
$ sudo apt-get update
$ sudo apt-get dist-upgrade
$ sudo dpkg --set-selections < packagelist
Now let's actually install it all:
Quote
$ sudo apt-get -u dselect-upgrade
Restore the System
What if we wanted to restore our system to an earlier
state by installing everything that's on our list and
uninstalling everything that's not? We can do that
too, but we need to be careful because this may entail
a radical change. Before restoring our package
selection states, we're going to deselect every
package, thereby marking them for uninstallation:
Quote
$ sudo dpkg --clear-selections
$ sudo dpkg --set-selections < packagelist
Now, every package not on our list has been deselected
and everything on our list has been selected. Let's
commit the changes:
Quote
$ sudo apt-get -u dselect-upgrade
If we wanted to remove the configuration files of the
uninstalled packages, we'd do the following instead:
Quote
$ sudo apt-get -u dselect-upgrade --purge
Please don't forget to restore the package selection
states before running apt-get, or the whole system
would be uninstalled!
Wednesday, August 12, 2009
Outra opção pra gerenciar referências
Gostei da última sugestão do Rodrigo! Não sabia dessa opção do ADS. Eu tenho outra sugestão para gerenciar suas referências: o programa Kbib!
Gosto muito desse programa (do KDE) pra Linux, no qual vc pode inserir as informações dos papers preferidos. Basta copiar as informações Bibtex do site do ADS, criar nova entrada no Kbib e inserir as informações na aba de bibtex da nova entrada.
Ou então pode inserir manualmente cada uma das informações: autores, revista, volume, páginas, ano de publicação... Prefiro a primeira opção.
Assim, armazeno todas as informações num único arquivo bibtex e posso salvar todos os artigos numa pasta, mantendo todos reunidos sem precisar renomeá-los (pois o próprio programa associa a nova entrada ao arquivo PDF). Dependendo da origem do PDF, as informações podem ser baixadas pelo próprio programa (tanto via online quanto direto do PDF).
Depois na hora de escrever artigos ou teses, basta usar o proprio arquivo .bib das referências, tudo muito prático!
Gosto muito desse programa (do KDE) pra Linux, no qual vc pode inserir as informações dos papers preferidos. Basta copiar as informações Bibtex do site do ADS, criar nova entrada no Kbib e inserir as informações na aba de bibtex da nova entrada.
Ou então pode inserir manualmente cada uma das informações: autores, revista, volume, páginas, ano de publicação... Prefiro a primeira opção.
Assim, armazeno todas as informações num único arquivo bibtex e posso salvar todos os artigos numa pasta, mantendo todos reunidos sem precisar renomeá-los (pois o próprio programa associa a nova entrada ao arquivo PDF). Dependendo da origem do PDF, as informações podem ser baixadas pelo próprio programa (tanto via online quanto direto do PDF).
Depois na hora de escrever artigos ou teses, basta usar o proprio arquivo .bib das referências, tudo muito prático!
Wednesday, July 8, 2009
Coletando as referências da sua tese/dissertação de forma eficiente no ADS
Muitos na hora de escrever a sua tese/dissertação já passaram pela etapa tediosa de coletar as referências no formato Bibtex para incluir no documento. Eu gastei várias horas só fazendo isto, compilando as mais de duzentas referências da minha tese. =p
Aprendi recentemente que há uma maneira potencialmente muito mais rápida de fazer isto, usando um recurso do ADS chamado de Private Libraries (ver em My Account).
Para isto é necessário primeiro criar uma conta no ADS. Depois, à medida que você vai encontrando os artigos que você precisa no ADS, basta selecioná-los e clicar lá embaixo na opção add selected articles to private library. Depois você pode dar um nome para a lista de artigos em questão, por exemplo, Tese.
Agora vem a mágica. Para obter a lista de referências pronta no formato bibtex, basta acessar a lista de artigos Tese que você criou, selecionar todos os artigos, e selecionar o formato de saída bibtex. Pronto, chega de copiar e colar cada referência individual na tese!
P.S. Agradecimentos à Graziela Keller (IAG-USP) e ao Paulo Penteado (IAG-USP) pela dica quentíssima.
Aprendi recentemente que há uma maneira potencialmente muito mais rápida de fazer isto, usando um recurso do ADS chamado de Private Libraries (ver em My Account).
Para isto é necessário primeiro criar uma conta no ADS. Depois, à medida que você vai encontrando os artigos que você precisa no ADS, basta selecioná-los e clicar lá embaixo na opção add selected articles to private library. Depois você pode dar um nome para a lista de artigos em questão, por exemplo, Tese.
Agora vem a mágica. Para obter a lista de referências pronta no formato bibtex, basta acessar a lista de artigos Tese que você criou, selecionar todos os artigos, e selecionar o formato de saída bibtex. Pronto, chega de copiar e colar cada referência individual na tese!
P.S. Agradecimentos à Graziela Keller (IAG-USP) e ao Paulo Penteado (IAG-USP) pela dica quentíssima.
Dica para melhor uso do ADS
Existe uma maneira de pesquisar mais eficientemente os artigos no ADS que muitos desconhecem. Para pesquisar somente os artigos nos quais o autor B. A. FULANO é o primeiro autor, use a expressão no campo autor:
^fulano
Tão simples assim.
^fulano
Tão simples assim.
Tuesday, June 30, 2009
Python
Uma excelente dica para quem quer mudar de linguagem de programação é começar com Python. Uma ferramenta poderosa que, segundo pessoas que programam com ela dizem não deixa a desejar em nada para o IDL (sic). Uma boa dica de tutorial é o que segue:
http://www.scipy.org/wikis/topical_software/Tutorial
Cheio de aplicações a astronomia.
Abraços
http://www.scipy.org/wikis/topical_software/Tutorial
Cheio de aplicações a astronomia.
Abraços
Monday, June 8, 2009
Dicas para redação da sua tese/exame/dissertação
Pessoal, agora que recém terminei de escrever a minha tese, vou tomar um tempinho pra dar umas dicas sobre como elaborar a sua tese de doutorado/exame de doutorado/dissertação de mestrado com o LateX.
Infelizmente o IF não possui um modelo padrão para elaborar a tese. O modelo de tese latex que tem circulado entre os alunos há alguns anos foi inicialmente elaborado pelo Irapuan Rodrigues, quando ele escreveu a sua tese em 1999. Posteriormente, quando escrevi a minha dissertação e posteriormente a tese, introduzi algumas pequenas melhorias no template do Irapa. Aos alunos do IF-UFRGS: quem quiser este template com as atualizações, é só me mandar um e-mail.
TESE-MAIN.TEX
O arquivo principal é o tese-main.tex, que delineia a estrutura geral da tese. Nele você define:
- qual o tipo de documento a ser gerado: dissertação (mastersthesis), tese (phdthesis) ou exame (exame)
- quais os pacotes latex que você vai precisar
- informações da tese: título, autor, orientadora etc
Na parte final do arquivo, você define a ordem em que os capítulos e apêndice(s) vão aparecer editando os comandos
\include{tese-capX}
onde tese-capX é o texto contido no arquivo tese-capX.tex. Eu sugiro editar cada capítulo em um arquivo tex separado. Caso um destes arquivos seja corrompido (por exemplo, devido a uma queda de luz), pelo menos a tese toda não é perdida.
ARQUIVOS *.STY, *.CLS
Os arquivos ifnatbib.sty, isolatin1.sty, stdclsdv.sty, iftese.cls, natbib.sty, tocbibind.sty definem as propriedades da formatação da tese. Recomendável não editá-los, a não ser que você realmente saiba o que está fazendo.
BIBLIOGRAFIA USANDO BIBTEX
O arquivo tese-refs.bib contém a bibliografia do documento no formato bibtex. Você vai que copiar e colar neste arquivo a entrada bibtex de cada artigo/livro etc que você cita no corpo da tese. Uma maneira fácil de obter as referência no formato bibtex é acessar a página do ADS, achar o artigo desejado - por exemplo este aqui ;) - e procurar o link "Bibtex entry for this abstract". É possível também listar as entradas bibtex para vários artigos ao mesmo tempo no ADS, selecionando a opção "BIBTEX reference list" no campo FORMAT da página do ADS.
Quando o artigo tiver sido publicado nas revistas usuais da astronomia (ApJ, A&A, MNRAS), tome o cuidado de alterar o campo na entrada bibtex fornecida pelo ADS de
journal = {\mnras}
para
journal = mnras (retire as chaves)
Desta forma, o nome da revista correspondente vai aparecer automaticamente, e você não vai precisar escrever o nome da revista por extenso na entrada bibtex.
Quando você altera o arquivo tese-refs.bib, simplesmente "latequear" a sua tese não vai atualizar a lista de referências resultante no arquivo DVI. É necessário também rodar o comando bibtex e depois latequear. Você pode rodar o shell script make.sh (sh make.sh) que faz isto automaticamente.
Update: Sobre as referências Bibtex, há uma dica quente no post "coletando as referências da sua tese/dissertação de forma eficiente no ADS". (08/7/2009)
SCRIPTS ÚTEIS
Além do make.sh, existem alguns outros scripts que podem ser úteis. Os arquivos *.sh são shell scripts para linux/mac, enquanto os arquivos *.bat são scripts que devem ser executados num prompt de comando do windows.
clean.sh (linux/mac), clean.bat (windows)
"Limpa" o diretório da tese, apagando os arquivos que são gerados quando você "latequeia" a tese.
backup.sh (linux/mac), backup.bat (windows)
Cria uma cópia de segurança dos arquivos da tese, gerando o arquivo backup.tar. No windows é necessário instalar o programa 7-zip e alterar o caminho até o executável deste programa no arquivo .bat.
EDITORES AMIGÁVEIS DE LATEX
Eis as minhas sugestões:
Linux: Kile, Texmaker
Windows: Texmaker, TeXnicCenter
Mac OS X: TeXShop (ver também os editores listados aqui)
É claro que há também Emacs, VI, etc, porém o nome desta seção é editores amigáveis.
DICIONÁRIO DE PORTUGUÊS
É útil ter para fácil consulta um bom dicionário de português durante a escrita da sua tese. Para quem quiser (somente alunos do IF-UFRGS), está disponível a versão eletrônica do Dicionário Aurélio, que roda no windows (e também Linux e Mac OS X via Wine).
CONVERTER FIGURAS PARA FORMATO POSTSCRIPT
É comum você precisar converter figuras de um formato bitmap (e.g. jpeg, bmp, png, gif etc) para o formato postscript (eps, ps). Recomendo fortemente usar o programa sam2p para efetuar tal conversão. No (K)Ubuntu, tal programa está disponível via Synaptic.
O sam2p gera arquivos postscript com tamanhos *muito* menores que os gerados via outros métodos, tais como usando o programa convert (que acessa a biblioteca ImageMagick) ou GIMP.
POSSÍVEIS PROBLEMAS COM ACENTUAÇÃO NOS ARQUIVOS *.TEX
Se você abrir os arquivos *.tex para edição e constatar que os acentos foram substituídos por caracteres estranhos, ou se o mesmo problema acontecer após você latequear a tese, leia as instruções abaixo.
Convém abordar outro problema comum encontrado durante a redação da tese. Dependendo do sistema operacional que você usa para editar os arquivos-textos latex, eles são salvos com um sistema de codificação de caracteres diferente. Por exemplo, no windows e no Suse Linux o sistema padrão é ISO-8859-1; no (K)Ubuntu/Debian linux o sistema é o UTF-8. Se você salvar o arquivo no sistema UTF-8 e abrí-lo no notepad do windows, vai perceber que os caracteres aparecem corrompidos.
É importante manter uma consistência no sistema de caracteres dos arquivos *.tex. Você também pode precisar configurar o seu editor de texto predileto para que ele reconheça o sistema de codificação caso ocorram problemas. Por exemplo, no caso do Kile, basta acessar o menu Tools -> Encoding. Convém notar que o editor TeXnicCenter do windows suporta somente o formato ISO-8859-1 (sistema padrão do windows), por este motivo eu prefiro o Texmaker quando uso windows.
Caso você use um S. O. que salve os arquivos no formato UTF-8, como eu fiz, é necessário carregar o pacote utf8x (ver arquivo tese-main.tex).
Para converter a codificação dos arquivos de um sistema para o outro, basta usar o comando iconv no linux/mac. Por exemplo, o comando
iconv --from-code=ISO-8859-1 --to-code=UTF-8 iso.txt > utf.txt
converte do sistema ISO-8859-1 para o UTF-8.
HOMOLOGAÇÃO DA TESE (25/6/2009)
Um aviso: para "homologar" a sua tese ou dissertação, não é mais necessário passar pelo crivo da Zuleika na biblioteca. Somente teses/dissertações da PPG Ensino de Física precisam passar pela checagem de referências da Zuleika agora.
Infelizmente o IF não possui um modelo padrão para elaborar a tese. O modelo de tese latex que tem circulado entre os alunos há alguns anos foi inicialmente elaborado pelo Irapuan Rodrigues, quando ele escreveu a sua tese em 1999. Posteriormente, quando escrevi a minha dissertação e posteriormente a tese, introduzi algumas pequenas melhorias no template do Irapa. Aos alunos do IF-UFRGS: quem quiser este template com as atualizações, é só me mandar um e-mail.
TESE-MAIN.TEX
O arquivo principal é o tese-main.tex, que delineia a estrutura geral da tese. Nele você define:
- qual o tipo de documento a ser gerado: dissertação (mastersthesis), tese (phdthesis) ou exame (exame)
- quais os pacotes latex que você vai precisar
- informações da tese: título, autor, orientadora etc
Na parte final do arquivo, você define a ordem em que os capítulos e apêndice(s) vão aparecer editando os comandos
\include{tese-capX}
onde tese-capX é o texto contido no arquivo tese-capX.tex. Eu sugiro editar cada capítulo em um arquivo tex separado. Caso um destes arquivos seja corrompido (por exemplo, devido a uma queda de luz), pelo menos a tese toda não é perdida.
ARQUIVOS *.STY, *.CLS
Os arquivos ifnatbib.sty, isolatin1.sty, stdclsdv.sty, iftese.cls, natbib.sty, tocbibind.sty definem as propriedades da formatação da tese. Recomendável não editá-los, a não ser que você realmente saiba o que está fazendo.
BIBLIOGRAFIA USANDO BIBTEX
O arquivo tese-refs.bib contém a bibliografia do documento no formato bibtex. Você vai que copiar e colar neste arquivo a entrada bibtex de cada artigo/livro etc que você cita no corpo da tese. Uma maneira fácil de obter as referência no formato bibtex é acessar a página do ADS, achar o artigo desejado - por exemplo este aqui ;) - e procurar o link "Bibtex entry for this abstract". É possível também listar as entradas bibtex para vários artigos ao mesmo tempo no ADS, selecionando a opção "BIBTEX reference list" no campo FORMAT da página do ADS.
Quando o artigo tiver sido publicado nas revistas usuais da astronomia (ApJ, A&A, MNRAS), tome o cuidado de alterar o campo na entrada bibtex fornecida pelo ADS de
journal = {\mnras}
para
journal = mnras (retire as chaves)
Desta forma, o nome da revista correspondente vai aparecer automaticamente, e você não vai precisar escrever o nome da revista por extenso na entrada bibtex.
Quando você altera o arquivo tese-refs.bib, simplesmente "latequear" a sua tese não vai atualizar a lista de referências resultante no arquivo DVI. É necessário também rodar o comando bibtex e depois latequear. Você pode rodar o shell script make.sh (sh make.sh) que faz isto automaticamente.
Update: Sobre as referências Bibtex, há uma dica quente no post "coletando as referências da sua tese/dissertação de forma eficiente no ADS". (08/7/2009)
SCRIPTS ÚTEIS
Além do make.sh, existem alguns outros scripts que podem ser úteis. Os arquivos *.sh são shell scripts para linux/mac, enquanto os arquivos *.bat são scripts que devem ser executados num prompt de comando do windows.
clean.sh (linux/mac), clean.bat (windows)
"Limpa" o diretório da tese, apagando os arquivos que são gerados quando você "latequeia" a tese.
backup.sh (linux/mac), backup.bat (windows)
Cria uma cópia de segurança dos arquivos da tese, gerando o arquivo backup.tar. No windows é necessário instalar o programa 7-zip e alterar o caminho até o executável deste programa no arquivo .bat.
EDITORES AMIGÁVEIS DE LATEX
Eis as minhas sugestões:
Linux: Kile, Texmaker
Windows: Texmaker, TeXnicCenter
Mac OS X: TeXShop (ver também os editores listados aqui)
É claro que há também Emacs, VI, etc, porém o nome desta seção é editores amigáveis.
DICIONÁRIO DE PORTUGUÊS
É útil ter para fácil consulta um bom dicionário de português durante a escrita da sua tese. Para quem quiser (somente alunos do IF-UFRGS), está disponível a versão eletrônica do Dicionário Aurélio, que roda no windows (e também Linux e Mac OS X via Wine).
CONVERTER FIGURAS PARA FORMATO POSTSCRIPT
É comum você precisar converter figuras de um formato bitmap (e.g. jpeg, bmp, png, gif etc) para o formato postscript (eps, ps). Recomendo fortemente usar o programa sam2p para efetuar tal conversão. No (K)Ubuntu, tal programa está disponível via Synaptic.
O sam2p gera arquivos postscript com tamanhos *muito* menores que os gerados via outros métodos, tais como usando o programa convert (que acessa a biblioteca ImageMagick) ou GIMP.
POSSÍVEIS PROBLEMAS COM ACENTUAÇÃO NOS ARQUIVOS *.TEX
Se você abrir os arquivos *.tex para edição e constatar que os acentos foram substituídos por caracteres estranhos, ou se o mesmo problema acontecer após você latequear a tese, leia as instruções abaixo.
Convém abordar outro problema comum encontrado durante a redação da tese. Dependendo do sistema operacional que você usa para editar os arquivos-textos latex, eles são salvos com um sistema de codificação de caracteres diferente. Por exemplo, no windows e no Suse Linux o sistema padrão é ISO-8859-1; no (K)Ubuntu/Debian linux o sistema é o UTF-8. Se você salvar o arquivo no sistema UTF-8 e abrí-lo no notepad do windows, vai perceber que os caracteres aparecem corrompidos.
É importante manter uma consistência no sistema de caracteres dos arquivos *.tex. Você também pode precisar configurar o seu editor de texto predileto para que ele reconheça o sistema de codificação caso ocorram problemas. Por exemplo, no caso do Kile, basta acessar o menu Tools -> Encoding. Convém notar que o editor TeXnicCenter do windows suporta somente o formato ISO-8859-1 (sistema padrão do windows), por este motivo eu prefiro o Texmaker quando uso windows.
Caso você use um S. O. que salve os arquivos no formato UTF-8, como eu fiz, é necessário carregar o pacote utf8x (ver arquivo tese-main.tex).
Para converter a codificação dos arquivos de um sistema para o outro, basta usar o comando iconv no linux/mac. Por exemplo, o comando
iconv --from-code=ISO-8859-1 --to-code=UTF-8 iso.txt > utf.txt
converte do sistema ISO-8859-1 para o UTF-8.
HOMOLOGAÇÃO DA TESE (25/6/2009)
Um aviso: para "homologar" a sua tese ou dissertação, não é mais necessário passar pelo crivo da Zuleika na biblioteca. Somente teses/dissertações da PPG Ensino de Física precisam passar pela checagem de referências da Zuleika agora.
Sunday, June 7, 2009
Liberar espaço desperdiçado pelo Windows Vista
Galera, descobri que o Windows Vista usa um monte de espaço do seu HD para armazenar cópias de arquivos (shadow copies na terminologia deles) e pontos de restauração, potencialmente 20% do tamanho do HD. No meu caso, o meu laptop tem uma partição de 130 GB de espaço separada para o Vista, e descobri que o vista estava reservando 21 GB (!!!) para gravar pontos de restauração e shadow copies. Exagero.
Para remediar isto, acesse este link. O comando
vssadmin list shadowstorage
lista o espaço que o system restore está usando. O comando
vssadmin Resize ShadowStorage /For=C: /On=C: /Maxsize=3GB
reajusta o tamanho alocado para o system restore. No meu caso, eu separo um espaço de 3 GB para os pontos de restauração. Dá até pra desativar os pontos de restauração automáticos, mas eu não recomendo isto.
Pronto, espaço milagrosamente liberado no HD!
Para remediar isto, acesse este link. O comando
vssadmin list shadowstorage
lista o espaço que o system restore está usando. O comando
vssadmin Resize ShadowStorage /For=C: /On=C: /Maxsize=3GB
reajusta o tamanho alocado para o system restore. No meu caso, eu separo um espaço de 3 GB para os pontos de restauração. Dá até pra desativar os pontos de restauração automáticos, mas eu não recomendo isto.
Pronto, espaço milagrosamente liberado no HD!
Thursday, April 9, 2009
Configurando o cedilha em teclados americanos no linux
Pra fazer o cedilha funcionar em teclados padrão americano (que não possuem a tecla cedilha) no linux, siga as instruções deste link:
Cedilha, Gnome, KDE e Ubuntu 8.04 em Inglês :: Vitor Pamplona
Depois de seguir as instruções, o ç vai funcionar em vez do famigerado ć. Barbada. Eu testei no Ubuntu 8.04 do meu laptop e funcionou.
Cedilha, Gnome, KDE e Ubuntu 8.04 em Inglês :: Vitor Pamplona
Depois de seguir as instruções, o ç vai funcionar em vez do famigerado ć. Barbada. Eu testei no Ubuntu 8.04 do meu laptop e funcionou.
Friday, April 3, 2009
O jogo da formação estelar
Descobri um joguinho na internet que ilustra conceitos de formação estelar. O jogo começa com uma nuvem molecular. O objetivo é botar supernovas nos pontos certos, que ao explodirem geram ondas de choque, comprimindo o gás, desencadeando colapso gravitacional e a formação de novas estrelas. Quanto menos supernovas tu explodires, e mais estrelas formares, maior a tua pontuação.
Confiram o jogo aqui. Descobri fuçando o blog Bad Astronomy.
Aparentemente eu sou ruim neste jogo. Não consegui nem 900 pontos... =P
Confiram o jogo aqui. Descobri fuçando o blog Bad Astronomy.
Aparentemente eu sou ruim neste jogo. Não consegui nem 900 pontos... =P
Wednesday, April 1, 2009
Dicas de programas: Stellarium e Celestia
Pessoal,
Não sei se todos conhecem estes programas: Celestia e Stellarium. São dois programas *gratuitos* para windows/linux/mac. Vale muito a pena baixá-los e instalá-los!
O Celestia é, conforme a sua web page: "The free space simulation that lets you explore our universe in three dimensions". Muito bom pra viajar pelos planetas e estrelas, e até mesmo "sair" da nossa galáxia.
O Stellarium é, conforme a sua web page: "It shows a realistic sky in 3D, just like what you see with the naked eye, binoculars or a telescope. It is being used in planetarium projectors. Just set your coordinates and go. " Ele mostra em tempo real o céu em qualquer lugar do mundo, semelhante a um planetário. Excelente!
Pra quem for auxiliar na Usina do Gasômetro e não tem muita experiência em "ler" o céu (assim como eu), recomendo fortemente brincar com o Stellarium. Muito divertido.
Bom proveito!
P.S. O Rogério sugeriu também o Kstars como alternativa ao Stellarium. Eu pessoalmente prefiro o Stellarium, que é mais "bonito". =)
Não sei se todos conhecem estes programas: Celestia e Stellarium. São dois programas *gratuitos* para windows/linux/mac. Vale muito a pena baixá-los e instalá-los!
O Celestia é, conforme a sua web page: "The free space simulation that lets you explore our universe in three dimensions". Muito bom pra viajar pelos planetas e estrelas, e até mesmo "sair" da nossa galáxia.
O Stellarium é, conforme a sua web page: "It shows a realistic sky in 3D, just like what you see with the naked eye, binoculars or a telescope. It is being used in planetarium projectors. Just set your coordinates and go. " Ele mostra em tempo real o céu em qualquer lugar do mundo, semelhante a um planetário. Excelente!
Pra quem for auxiliar na Usina do Gasômetro e não tem muita experiência em "ler" o céu (assim como eu), recomendo fortemente brincar com o Stellarium. Muito divertido.
Bom proveito!
P.S. O Rogério sugeriu também o Kstars como alternativa ao Stellarium. Eu pessoalmente prefiro o Stellarium, que é mais "bonito". =)
Wednesday, February 18, 2009
Rede wireless do departamento
Pessoal,
Para cadastrar o seu notebook é necessário que que você enviem um arquivo
para a Liliane. O arquivo é gerado com o seguinte comando (no linux):
/sbin/ifconfig > /tmp/wireless.txt
O arquivo será criado com o nome wireless.txt no diretório /tmp.
Mande este arquivo em anexo para liliane + if.ufrgs.br, juntamente com
as informações abaixo:
Nome:
Cargo/Função (Prof/Aluno/Funcionário/Visitante):
Sala:
Fone:
Para o cadastro no windows (somente para quem não tem linux, pois o
mesmo cadastro serve para ambos os sistemas operacionais) é necessário
contatar a Liliane.
Além desse cadastro a rede é protegida por uma senha, que estará a
disposição, de quem cadastrar o note, com a Liliane, Rodrigo, Rogério,
Charles, Rogemar.
Bom proveito a todos e use com responsabilidade!
Abraços a todos,
Rogério
Para cadastrar o seu notebook é necessário que que você enviem um arquivo
para a Liliane. O arquivo é gerado com o seguinte comando (no linux):
/sbin/ifconfig > /tmp/wireless.txt
O arquivo será criado com o nome wireless.txt no diretório /tmp.
Mande este arquivo em anexo para liliane + if.ufrgs.br, juntamente com
as informações abaixo:
Nome:
Cargo/Função (Prof/Aluno/Funcionário/Visitante):
Sala:
Fone:
Para o cadastro no windows (somente para quem não tem linux, pois o
mesmo cadastro serve para ambos os sistemas operacionais) é necessário
contatar a Liliane.
Além desse cadastro a rede é protegida por uma senha, que estará a
disposição, de quem cadastrar o note, com a Liliane, Rodrigo, Rogério,
Charles, Rogemar.
Bom proveito a todos e use com responsabilidade!
Abraços a todos,
Rogério
Wednesday, February 11, 2009
Alguns parâmetros para fazer o linux bootar em pcs/notebooks novos
Recentemente adquiri uma MB nova, da marca Phitronics e um HD-Sata II. E tive alguns problemas para bootar o Kubuntu 8.04. Começava o processo de boot e travava (na verdade problemas comuns enfrentados em MBs novas). Um colega teve o mesmo problema com o Mandriva em um notebook. Bom, a solução é simples. Basta adicionar a linha abaixo nas opções de boot.
noapic nolapic all-generic-ide irqpoll dma=off acpi=off
Espero que seja útil.
noapic nolapic all-generic-ide irqpoll dma=off acpi=off
Espero que seja útil.
Wednesday, January 14, 2009
Saturday, December 27, 2008
Tuesday, December 9, 2008
Dyson Spheres
Segue um texto interessante com uma idéia pra lá de bem sacada de aproveitamento eficiente de toda a energia irradiada pelo Sol (e de quebra, um método-tentativa de detecção de vida extraterrestre... o engraçado é que o trabalho é coisa séria!! hehehe)
http://blogs.discovermagazine.com/cosmicvariance/2008/12/02/no-dyson-spheres-found-yet/
Pra quem não conhece, o CosmicVariance é um blog muito legal sobre ciência mantido por alguns pesquisadores americanos (sérios, diga-se de passagem)
Abraços
http://blogs.discovermagazine.com/cosmicvariance/2008/12/02/no-dyson-spheres-found-yet/
Pra quem não conhece, o CosmicVariance é um blog muito legal sobre ciência mantido por alguns pesquisadores americanos (sérios, diga-se de passagem)
Abraços
Saturday, November 15, 2008
Tunelamento de SSH
Este post, é uma adaptação de um e-mail que a Lili mandou a algum tempo.
Espero que seja útil.
Abraços
Quer uma maneira fácil de acessar os arquivos de algum pcastro de casa?
Em um terminar digite:
ssh -L 2000:pcastroXX:22 frontdoor.if.ufrgs.br
Digite a senha do frontdoor (as alfas)
O pcastroXX é o pc que se quer acessar e o número 2000 pode ser qq acima de 1024.
Para copiar arquivos do pcastroXX, digitar em OUTRO terminal:
scp -P 2000 localhost:arquivo .
Não esqueça o ponto final Ele indica que os arquivos serão copiados para o diretório atual onde o camando esta sendo digitado!
Para transferir arquivos de casa para o pcastroXX:
scp -P 2000 arquivo localhost:
Para o caso de um diretório, não esqueça de por o -r, que indica cópia recusiva, ou seja tudo de dentro do diretório.
Ex:
Para copiar um diretório do pcastroXX para casa:
scp -r -P 2000 localhost:diretorio .
ou
Para copiar um diretório de casa para o pcastroxx
scp -r -P 2000 diretorio localhost:
Da ainda para abrir o konqueror (é tipo um windows explorer) e digitar:
fish://localhost:2000
Espero que seja útil.
Espero que seja útil.
Abraços
Quer uma maneira fácil de acessar os arquivos de algum pcastro de casa?
Em um terminar digite:
ssh -L 2000:pcastroXX:22 frontdoor.if.ufrgs.br
Digite a senha do frontdoor (as alfas)
O pcastroXX é o pc que se quer acessar e o número 2000 pode ser qq acima de 1024.
Para copiar arquivos do pcastroXX, digitar em OUTRO terminal:
scp -P 2000 localhost:arquivo .
Não esqueça o ponto final Ele indica que os arquivos serão copiados para o diretório atual onde o camando esta sendo digitado!
Para transferir arquivos de casa para o pcastroXX:
scp -P 2000 arquivo localhost:
Para o caso de um diretório, não esqueça de por o -r, que indica cópia recusiva, ou seja tudo de dentro do diretório.
Ex:
Para copiar um diretório do pcastroXX para casa:
scp -r -P 2000 localhost:diretorio .
ou
Para copiar um diretório de casa para o pcastroxx
scp -r -P 2000 diretorio localhost:
Da ainda para abrir o konqueror (é tipo um windows explorer) e digitar:
fish://localhost:2000
Espero que seja útil.
Friday, November 14, 2008
Extrair imagens de arquivo PDF
Há um comando interessante para retirar figuras de dentro de um arquivo PDF, chama-se pdfimages: http://linuxcommand.org/man_pages/pdfimages1.html
Por exemplo, temos um arquivo chamado paper.pdf do qual queremos retirar as figuras para incluí-las em uma apresentação, então podemos fazer:
pdfimages paper.pdf paper
onde papaer.pdf é o arquivo origem e "paper" é um radical comum a todas as imagens extraidas (paper-000.pbm, paper-001.pbm, etc).
O formato padrão de saída é pbm que pode ser convertido para outros formatos usando o comando convert do pacote imagemagick.
Há algumas configurações possíveis, como por exemplo escolher o intervalo de páginas das quais se quer retirar figuras. Basta ler o link acima.
Amplexos.
Por exemplo, temos um arquivo chamado paper.pdf do qual queremos retirar as figuras para incluí-las em uma apresentação, então podemos fazer:
pdfimages paper.pdf paper
onde papaer.pdf é o arquivo origem e "paper" é um radical comum a todas as imagens extraidas (paper-000.pbm, paper-001.pbm, etc).
O formato padrão de saída é pbm que pode ser convertido para outros formatos usando o comando convert do pacote imagemagick.
Há algumas configurações possíveis, como por exemplo escolher o intervalo de páginas das quais se quer retirar figuras. Basta ler o link acima.
Amplexos.
Wednesday, November 12, 2008
Converter entre UTF-8 e iso8859-1
Para quem tem problemas com os acentos quando abre os arquivos do latex em computadores diferentes este programinha pode ser útil.
Fonte: http://jfmitre.com/2006/05/convertendo-arquivos-utf-8-em-iso-8859.html
****daqui em diante foi transcrito do site acima****
iconv -f codificacao_de_origem -t codificacao_de_saida arquivo
Assim para converter UTF-8 para ISO-8859-1 temos:
iconv -f utf-8 -t iso-8859-1 arquivo
Para o contrário utilizamos:
iconv -f iso-8859-1 -t utf-8 arquivo
É necessário redirecionar a saida de arquivo para algum lugar, algo como:
iconv -f utf-8 -t iso-8859-1 arquivo > novo_arquivo
Sendo assim, eu acrescentei ao meu ~/.bashrc* as seguintes linhas
alias iso2utf='iconv -f iso-8859-1 -t utf-8'
alias utf2iso='iconv -f utf-8 -t iso-8859-1'
Agora quando eu quiser converter um tipo de arquivo em outro, eu só preciso usar o iso2utf ou o utf2iso
Fonte: http://jfmitre.com/2006/05/convertendo-arquivos-utf-8-em-iso-8859.html
****daqui em diante foi transcrito do site acima****
Recentemente tive alguns problemas com codificação de alguns arquivos e do próprio sistema (algumas coisas ainda não resolvidas, mas isso é outro assunto!).
O fato é que tive que fazer uma pesquisa sobre como converter um tipo de arquivo em outro. O que me impressionou não foi a dificuldade de achar uma solução, mas a complexidade de algumas soluções que eu encontrei. Pensei que certamente tal complexidade não seria necessária e estava certo !
Encontrei uma dica no rodapé do site das FunçõesZZ ensinando justamente como converter o arquivo das FunçõesZZ, que é escrito em ISO-8859-1, em UTF-8.
O comando é muito simples: iconv
Faz parte da libc6, ou seja, todo mundo têm instalado, e possuí sintaxe simples.
iconv -f codificacao_de_origem -t codificacao_de_saida arquivo
Assim para converter UTF-8 para ISO-8859-1 temos:
iconv -f utf-8 -t iso-8859-1 arquivo
Para o contrário utilizamos:
iconv -f iso-8859-1 -t utf-8 arquivo
É necessário redirecionar a saida de arquivo para algum lugar, algo como:
iconv -f utf-8 -t iso-8859-1 arquivo > novo_arquivo
Sendo assim, eu acrescentei ao meu ~/.bashrc* as seguintes linhas
alias iso2utf='iconv -f iso-8859-1 -t utf-8'
alias utf2iso='iconv -f utf-8 -t iso-8859-1'
Agora quando eu quiser converter um tipo de arquivo em outro, eu só preciso usar o iso2utf ou o utf2iso
Tuesday, November 11, 2008
J-Track 3D
O J-Track 3D é uma representação tridimensional mostrando a posição de cerca de 900 satélites que orbitam a Terra. Pode-se selecionar satélites específicos e observar suas órbitas. Podemos também obter informações como velocidade e altitude. Segue o link:
http://science.nasa.gov/Realtime/jtrack/3d/JTrack3d.html
Colaboração de Guilherme Couto
http://science.nasa.gov/
Colaboração de Guilherme Couto
Monday, November 10, 2008
Simulations Predict Where We Can Find Dark Matter
O Fermi vai "bombar" galera!
==============================
Simulations by the Virgo team show how the Milky Way's halo grew through a series of violent collisions and mergers from millions of much smaller clumps that emerged from the Big Bang. ... If Fermi does detect the predicted emission from the Milky Way's smooth inner halo, then it may, if we are lucky, also see gamma-rays from small (and otherwise invisible) clumps of dark matter which happen to lie particularly close to the Sun. ... The largest simulation took 3.5 million processor hours to complete. Volker Springel was responsible for shepherding the calculation through the machine and said: 'At times I thought it would never finish.' Max Planck Director, Professor Simon White, remarked that 'These calculations finally allow us to see what the dark matter distribution should look like near the Sun where we might stand a chance of detecting it.
Link original.
Via Slashdot.
==============================
Simulations by the Virgo team show how the Milky Way's halo grew through a series of violent collisions and mergers from millions of much smaller clumps that emerged from the Big Bang. ... If Fermi does detect the predicted emission from the Milky Way's smooth inner halo, then it may, if we are lucky, also see gamma-rays from small (and otherwise invisible) clumps of dark matter which happen to lie particularly close to the Sun. ... The largest simulation took 3.5 million processor hours to complete. Volker Springel was responsible for shepherding the calculation through the machine and said: 'At times I thought it would never finish.' Max Planck Director, Professor Simon White, remarked that 'These calculations finally allow us to see what the dark matter distribution should look like near the Sun where we might stand a chance of detecting it.
Link original.
Via Slashdot.
Subscribe to:
Posts (Atom)